全国の小学生から1000人を 無作為抽出 したとします。選ばれた1000人は全国に散らばるので、調査員が1人ずつ訪ねて回るなら、移動だけで予算が尽きます。名簿どおりに選ぶことと、実際に会いに行けることは別の問題です。
クラスター抽出法は、母集団 をあらかじめひとまとまりの集団(クラスター)に分けたうえで、要素ではなくクラスターのほうを無作為に選ぶ方法です。選ばれたクラスターに属する要素は、全部調べます。集落抽出法とも呼ばれます。
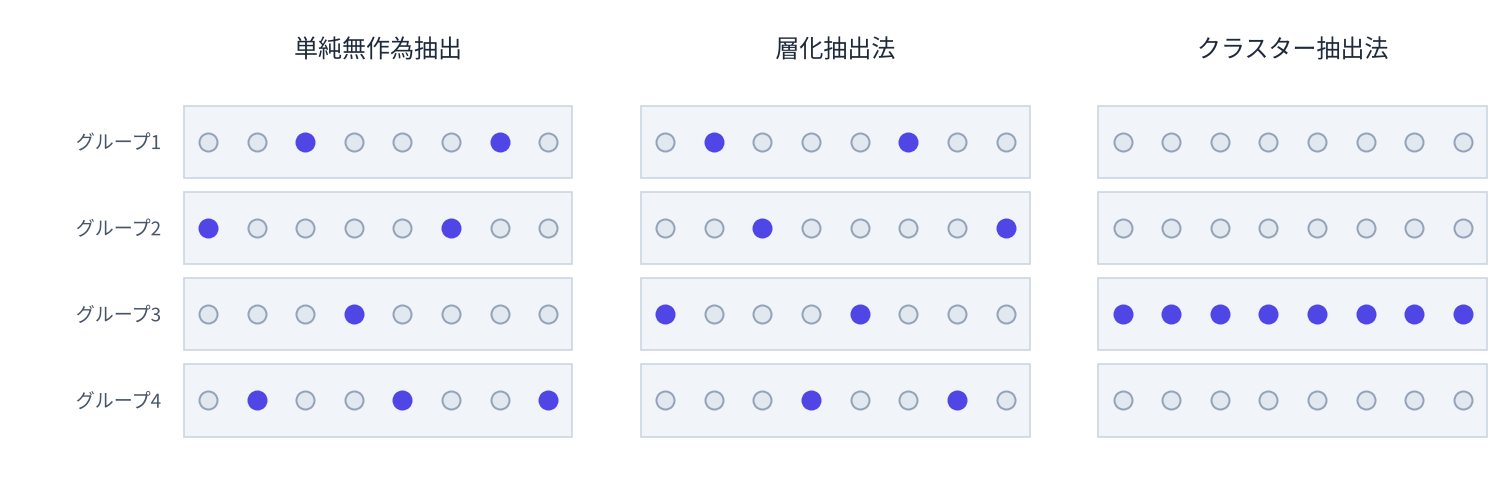
図の3つは、標本の大きさがどれも8で揃っています。違うのは取る場所だけです。左の単純無作為抽出では、グループごとの人数が 2, 2, 1, 3 と揃いません。中央の 層化抽出法 は各グループから2つずつを必ず取り、右のクラスター抽出法は選ばれたグループ以外からは1つも取らない——グループ1・2・4が薄いままなのはそのためです。母集団をグループに分ける点まで層化と同じで、その先が正反対になっています。
層内の似かたと精度の関係も逆向きです。層化は層の中が似ているほど有利でしたが、クラスター抽出法はクラスターの中が似ていると不利になります。同じような回答が重なるだけで、新しい情報が増えないからです。都合がよいのは、ひとつのクラスターの中に母集団と同じような幅があり、クラスター同士は似ている場合です。
市内の小学校20校(各校200人・計4000人)から400人を選んで、通学時間を調べます。学校をクラスターとし、20校から2校を無作為に選んで、その2校の児童全員に聞くことにしました。
費用の差ははっきりしています。この方法なら訪問先は2校で済みます。4000人から直接400人を選んでいたら、選ばれた児童は20校に散らばるので、ほぼすべての学校を回ることになったはずです。
代償は精度に現れます。通学時間は、学校の位置でおおよそ決まってしまう値です。駅前の学校が選ばれれば短い時間ばかりが、郊外の学校が選ばれれば長い時間ばかりが集まります。同じ学校の児童は互いに似ているので、400人分の値があっても、そこに含まれている情報は「2校分」に近いところまで目減りします。
手を打つとすれば、選ぶ学校の数を増やすことです。ただし各校の全員を調べるかぎり、学校を増やせばそのぶん人数も増えて費用が戻ってしまいます。1校あたりの人数を減らして学校の数を増やす、という抜け道もあり、そちらは 多段抽出法 になります。
ある航空会社が搭乗客の満足度を調べるにあたり、その日の便のうち2便を無作為に選び、選ばれた便の搭乗客全員に回答してもらいました。この抽出法はどれですか。
層化抽出法とクラスター抽出法の違いとして正しいものはどれですか。
クラスター抽出法で推定の精度が落ちやすいのは、どのような場合ですか。